
Anthropic ha presentato Claude Sonnet 5.5, il secondo modello della famiglia Claude 5.5 dopo Opus 5.5, arrivato appena sei giorni fa. Il prezzo resta quello di Sonnet 5, ma secondo l'azienda il nuovo modello genera risposte oltre il 30% più velocemente e costa fino al 30% in meno per ogni compito, perché consuma meno token per arrivare allo stesso risultato.
Il dato più interessante però è un altro: in diversi test pubblicati da Anthropic, Sonnet 5.5 si avvicina molto a Opus 5.5 pur costando la metà per token. Il modello è disponibile da oggi su Claude, via API e su Amazon Web Services, Google Cloud e Microsoft Azure.
Sonnet 5.5 si avvicina a Opus 5.5
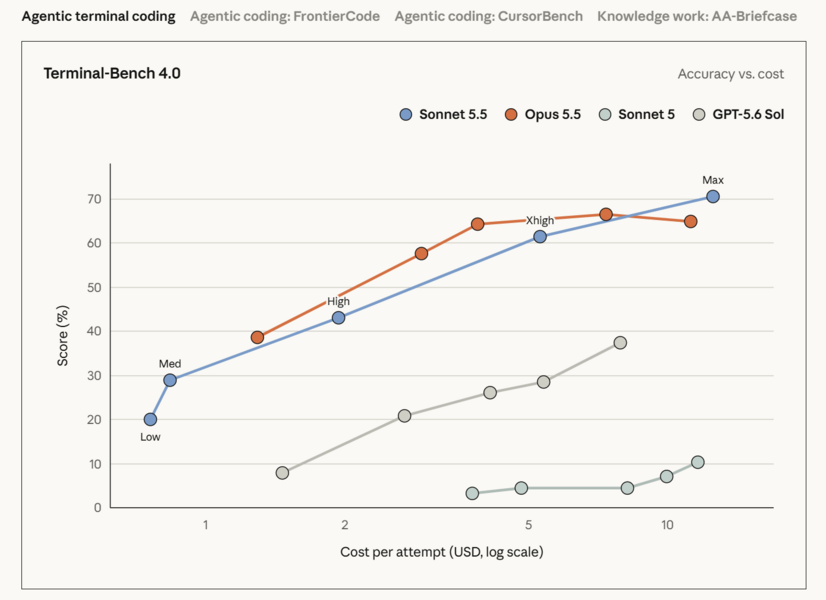
Su Terminal-Bench 4.0, che misura la capacità di completare compiti di programmazione in più passaggi dal terminale, Sonnet 5.5 ottiene il 70,6%. Sonnet 5 si fermava al 10,3% e Opus 5.5, al suo livello di ragionamento più alto, arriva al 66,4%. Su CursorBench 4.0, costruito su sessioni reali dell'editor Cursor, il nuovo modello passa dal 34,1% al 55,5%, circa due punti sotto Opus 5.5. Nel computer use, cioè l'uso autonomo di un computer attraverso l'interfaccia grafica, segna l'80,1% su OSWorld 2.1 contro l'81,8% del modello superiore.
Anche nel lavoro d'ufficio la distanza quasi scompare. Su GDPval-AA, che valuta compiti reali di 44 professioni, Sonnet 5.5 totalizza 1.844 punti contro i 1.846 di Opus 5.5 e i 1.449 di Sonnet 5. Nessun Sonnet prima era riuscito a finire Pokémon Rosso guardando solo gli screenshot, un test informale su visione e compiti lunghi.
Sono dati del produttore, e quelli di GDPval-AA sono stati raccolti da Artificial Analysis su una versione di prova con un bug poi corretto. La stessa Anthropic avverte che i benchmark raccontano solo una parte della storia: nei lavori complessi e aperti, che richiedono giudizio prolungato, Opus 5.5 resta nettamente più forte.
Stesso listino, conto più basso
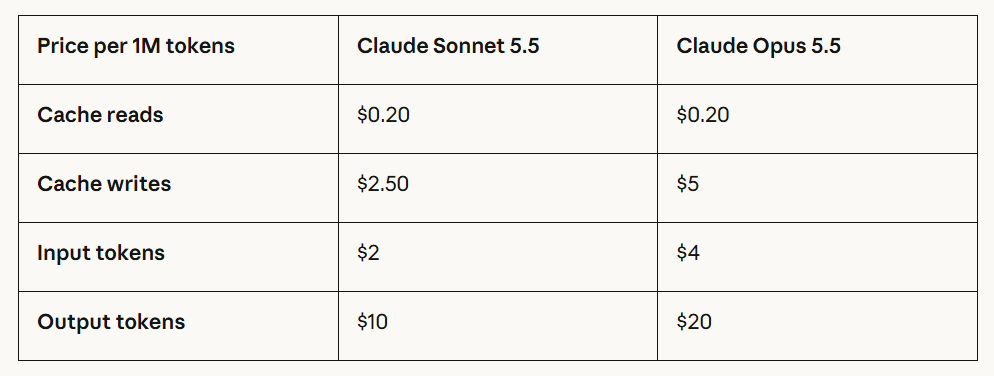
Sonnet 5.5 costa 2 dollari per milione di token in ingresso, 10 dollari in uscita e 0,20 dollari per le cache reads, cioè la rilettura di contesto già elaborato. Opus 5.5 costa il doppio su ingresso e uscita, rispettivamente 4 e 20 dollari. Il risparmio più consistente arriva però dall'efficienza. Secondo Anthropic, su diversi benchmark Sonnet 5.5 con effort basso o medio supera il miglior risultato di Sonnet 5 spendendo circa un decimo per compito. L'effort è l'impostazione che regola quanto a lungo il modello ragiona: nelle app e in Claude Code il valore predefinito è Medium, sulla Claude Platform è High.
Alcune aziende che hanno provato il modello in anteprima riportano risultati nella stessa direzione. Balyasny Asset Management dichiara che, su 2.441 compiti finanziari, Sonnet 5.5 ha usato circa 121.000 token per risposta contro i 497.000 di Sonnet 5. Zendesk parla invece di ticket di assistenza gestiti il 20% più velocemente.
Lo stesso prezzo di GPT-6 Sol
Il listino coincide con quello di GPT-6 Sol, il modello intermedio lanciato da OpenAI la scorsa settimana, che costa anch'esso 2 e 10 dollari per milione di token. Anthropic lo usa come termine di paragone diretto: su FrontierCode, un test che verifica se le modifiche al codice verrebbero accettate senza interventi umani, Sonnet 5.5 con effort High raggiunge il miglior punteggio di GPT-6 Sol con circa un quinto del costo per compito, sempre secondo l'azienda.
La logica è quella già vista con Claude Fable 5.1: i modelli di punta spostano in avanti le capacità, le fasce inferiori le rendono sostenibili su milioni di richieste. Il prossimo passo è Claude Haiku 5.5, pensato per applicazioni ad alto volume e a basso costo, atteso nelle prossime settimane.
Primo Sonnet con i filtri per la cybersecurity
Secondo Anthropic, le capacità di Sonnet 5.5 nella sicurezza informatica sono paragonabili a quelle di Opus 5. Per questo è il primo modello della fascia a debuttare con protezioni simili a quelle di Opus 5.5. Trovare e correggere bug nel proprio codice resta possibile, mentre le richieste considerate più rischiose passano in modo visibile a Sonnet 5. I professionisti della difesa informatica potranno presto chiedere un accesso più ampio tramite il Cyber Verification Program.
È anche il primo Sonnet con classificatori contro la distillazione, la pratica con cui migliaia di account falsi vengono usati per estrarre le capacità di un modello e replicarle in sistemi privi di protezioni.
Per aziende e sviluppatori la domanda ora cambia. Se i test indipendenti confermeranno distanze così ridotte, in molti flussi di lavoro quotidiani pagare il doppio per Opus 5.5 potrebbe non avere più molto senso.


