Mistral Large 4 si può ora scaricare ed eseguire sui propri sistemi. Dopo l’anteprima pubblica, l’azienda francese ha rilasciato i pesi del modello, cioè i valori numerici che ne determinano il comportamento. Per imprese e ricercatori europei significa poter utilizzare e adattare un’AI avanzata senza dipendere necessariamente dal servizio online di chi l’ha sviluppata.
La disponibilità dei file, però, non lo trasforma in un chatbot per qualsiasi portatile. Large 4, soprannominato Le Chonk, contiene circa mille miliardi di parametri: anche le versioni molto compresse richiedono centinaia di gigabyte di memoria.
Cosa cambia dopo l’anteprima
Il modello accetta testo e immagini e produce testo. Può analizzare documenti, lavorare sul codice e richiamare strumenti esterni nelle applicazioni che li mettono a disposizione. Supporta un contesto massimo di circa un milione di token, le unità in cui viene suddiviso il testo: la capacità effettivamente utilizzabile dipende anche dalla configurazione del servizio.
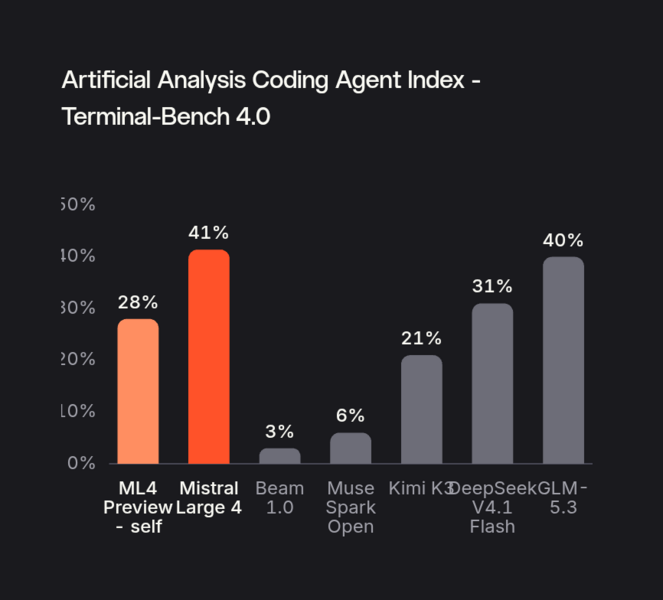
Secondo Mistral, il lavoro successivo all’anteprima ha migliorato soprattutto programmazione, sicurezza informatica ed efficienza. Su Terminal-Bench 4.0, una valutazione di attività svolte nel terminale, l’azienda dichiara un risultato del 41%, con un progresso di 13 punti percentuali e il 30% di token in uscita in meno. Sono risultati pubblicati dal produttore, non una nostra prova.
Un modello europeo sotto il proprio controllo
Mistral dichiara di averlo addestrato da zero nei propri data center europei, con 3.800 GPU NVIDIA Grace Blackwell. È un elemento industriale rilevante: l’Europa dispone di un modello sviluppato sul proprio territorio che altre organizzazioni possono utilizzare come base. L’infrastruttura resta però legata anche a tecnologia americana.
Per un’azienda italiana, l’utilità concreta potrebbe essere un assistente che consulta documentazione interna o aiuta a correggere software sui server aziendali. Se l’intero sistema è configurato per operare internamente, quei contenuti non devono essere inviati a un servizio AI esterno. L’accesso ai pesi permette inoltre di mantenere una versione e personalizzarla.
È una questione di controllo che attraversa molti dei temi di tecnologia e intelligenza artificiale: chi decide dove gira il software, quando aggiornarlo e quali dati può raggiungere? Un modello europeo amplia le alternative, ma non rende automaticamente riservata ogni applicazione che lo utilizza.

Aperto, con una condizione sulla licenza
La definizione precisa è open weight: i pesi sono disponibili. Questo non equivale, da solo, a pubblicare tutti i dati e tutti gli strumenti necessari per riprodurre l’addestramento.
La Mistral Ecosystem Open-Weight License consente utilizzo, modifica e personalizzazione, anche commerciale. Introduce però una condizione per le imprese che offrono modelli come servizio, il cosiddetto Model-as-a-Service: per quell’attività serve una licenza commerciale separata. Presentarlo semplicemente come “open source senza restrizioni” sarebbe quindi scorretto.
Mistral Large 4 in locale: quanta memoria serve
Large 4 usa un’architettura Mixture-of-Experts, che attiva soltanto una parte dei suoi componenti per ogni token. I parametri attivi sono circa 49 miliardi, oppure 52 includendo gli strati di ingresso e uscita. Questo riduce il calcolo, ma non elimina la necessità di conservare e rendere accessibile il resto del modello.
La quantizzazione riduce la precisione numerica dei pesi e il loro ingombro, con possibili compromessi nella qualità. La guida Unsloth indica questi ordini di grandezza per le proprie versioni, aggiornati a fine ottobre 2026.
| Versione quantizzata | Memoria complessiva indicativa |
|---|---|
| 1 bit | Da 256 a 270 GB |
| 2 bit | Da 310 a 390 GB |
| 4 bit | 630 GB |
| 8 bit | 1,2 TB |
Si tratta di RAM più memoria video, oppure memoria unificata: non di spazio SSD. Le prestazioni dipendono da dove risiedono i dati e dalla velocità dei trasferimenti. Servono anche margine per sistema operativo e conversazione, oltre allo spazio per scaricare i file. Un normale computer con 32 o 64 GB, e persino una macchina con 128 GB, resta fuori da questi requisiti.
Per l’esecuzione si possono usare versioni compatibili di llama.cpp con file GGUF, oppure vLLM e SGLang su infrastrutture server. Hugging Face documenta, per esempio, una configurazione FP8 con otto NVIDIA H200. Scaricare i pesi non richiede di ripetere l’addestramento, ma servono competenze per configurare memoria, contesto e software.
Il vantaggio più immediato riguarda quindi organizzazioni capaci di gestire quell’infrastruttura. Per gli altri resta l’accesso online: i pesi sono disponibili, l’hardware e il lavoro per farli funzionare hanno ancora un costo.


