Mistral torna nella corsa ai grandi modelli di intelligenza artificiale con una proposta che riguarda soprattutto chi deve portarli dentro un’azienda. Il 6 ottobre la società francese ha presentato Mistral Large 4, soprannominato Le Chonk: è disponibile in anteprima attraverso le API, le interfacce con cui gli sviluppatori lo collegano alle proprie applicazioni. La pubblicazione dei pesi, i parametri appresi durante l’addestramento necessari per eseguirlo autonomamente, è invece prevista entro fine ottobre.
La distinzione conta. Oggi si può provare un servizio ospitato da Mistral; quando arriveranno i pesi, sarà possibile valutare anche un’installazione sotto il proprio controllo. Per un’impresa che lavora con codice riservato, documentazione industriale o informazioni sensibili, questa possibilità può pesare nella scelta quanto la qualità delle risposte. Ed è su questo terreno che l’azienda europea vuole competere.
Quanto è grande Mistral Large 4
La scheda tecnica ufficiale indica 1.050 miliardi di parametri complessivi e 49 miliardi attivi. Il modello utilizza un’architettura Mixture of Experts, abbreviata MoE: durante l’elaborazione viene coinvolta soltanto una parte dei suoi componenti, selezionata di volta in volta. Il vantaggio è contenere il calcolo necessario rispetto a un sistema che attivasse sempre tutti i parametri.
Non significa però poterlo trattare come un modello da 49 miliardi di parametri quando si progetta l’infrastruttura. Il resto deve comunque essere conservato e reso accessibile: memoria, comunicazione tra acceleratori e gestione delle richieste rimangono problemi concreti. Avere i pesi disponibili non rende automaticamente economica l’esecuzione, soprattutto per chi non dispone già di un’infrastruttura dedicata.
Large 4 è multimodale, quindi può elaborare anche immagini oltre al testo. La documentazione riporta una finestra di contesto da un milione di token, le unità in cui vengono suddivisi i contenuti. È lo spazio a disposizione per istruzioni, materiali e conversazione, utile quando occorre consultare documenti lunghi. Non è però una misura della precisione: accettare un archivio corposo e trovare sempre il dettaglio giusto al suo interno sono capacità diverse.
Per dare una proporzione al salto, Mistral Large 3 aveva 675 miliardi di parametri totali, 41 miliardi attivi e un contesto da 256.000 token. Cresce molto la dimensione complessiva, mentre l’aumento della parte attivata a ogni passaggio è più contenuto. Sono indicazioni sull’architettura, non una percentuale di miglioramento nelle risposte.
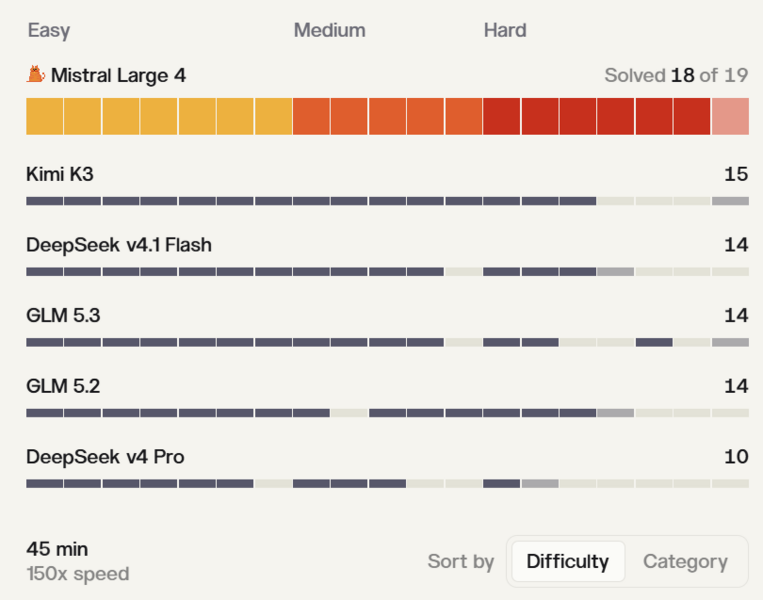
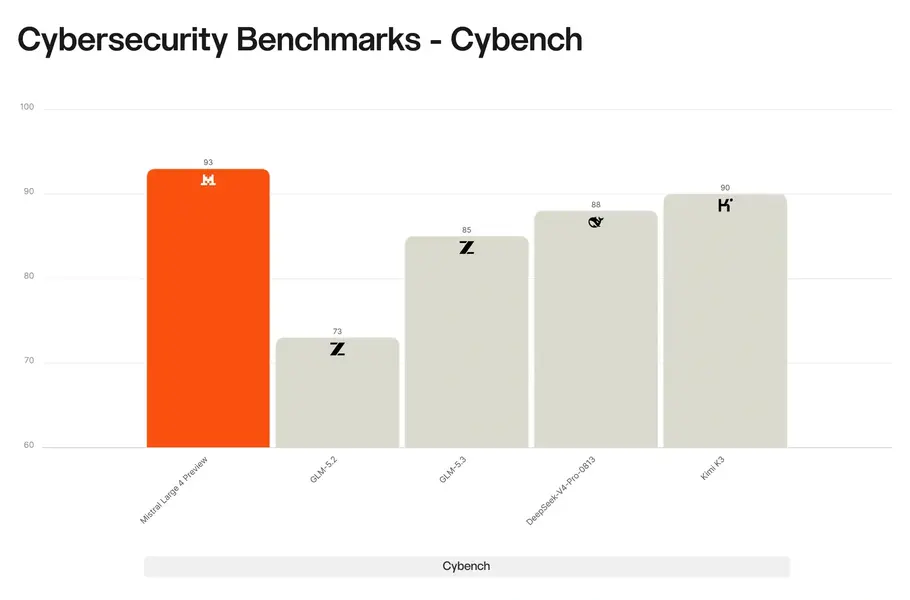
Il risultato più interessante riguarda la sicurezza
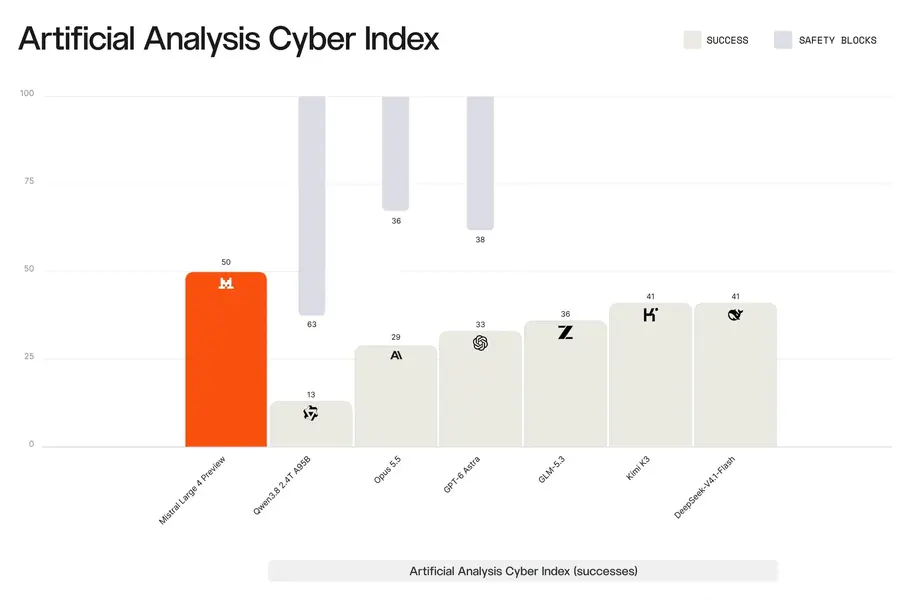
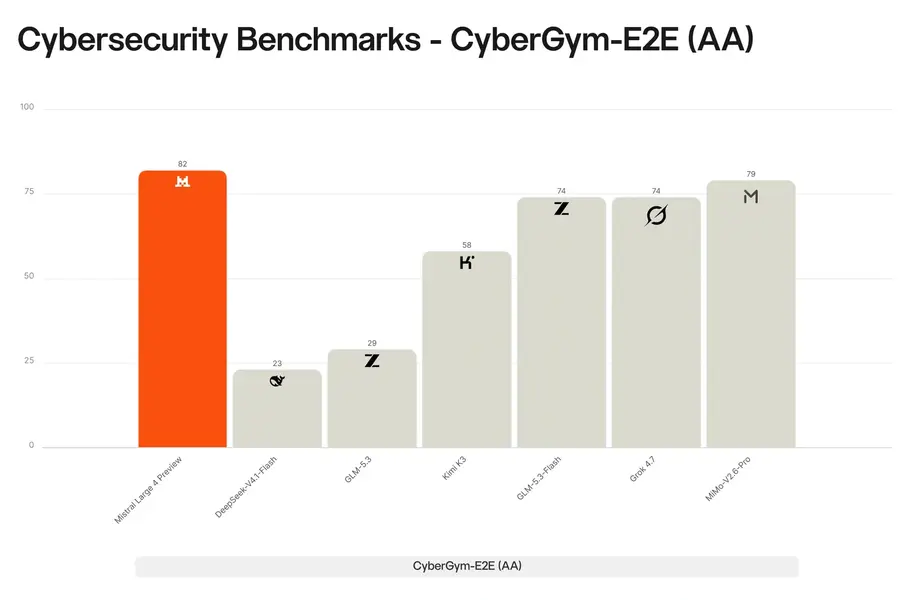
Nel benchmark indipendente CyberGym-E2E-AA di Artificial Analysis, Large 4 Preview ottiene l’81,7%, il punteggio più alto nella classifica consultata al lancio. Il test riguarda vulnerabilità reali in progetti open source scritti in C e C++: l’agente deve produrre un input che mandi in errore il programma, correggere il problema e preservare il funzionamento verificato dai test del progetto.
C’è una precisazione nella metodologia che rende il dato più leggibile. Il controllo che la modifica risolva anche la vulnerabilità originaria viene registrato separatamente e non contribuisce al punteggio. Quell’81,7% non va quindi tradotto in “risolve definitivamente otto falle su dieci”. Misura il completamento di una sequenza definita di operazioni, in un ambiente controllato.
Mistral collega queste capacità alla libertà di eseguire il modello con regole proprie: secondo l’azienda, i filtri dei servizi chiusi possono bloccare anche ricerche difensive legittime. Il problema esiste sul piano operativo: per verificare una falla occorre spesso riprodurre un comportamento pericoloso, e distinguere una verifica autorizzata da un attacco richiede contesto.
La disponibilità dei pesi sposta questa decisione verso chi gestisce il sistema. Comporta anche una responsabilità maggiore nel definire accessi, permessi e controlli. Prima del rilascio, Mistral prevede verifiche con esperti di sicurezza, partner selezionati e autorità, ai quali offrirà una versione con moderazione ridotta e capacità informatiche ampliate.
Agenti e immagini: cosa misurano i test
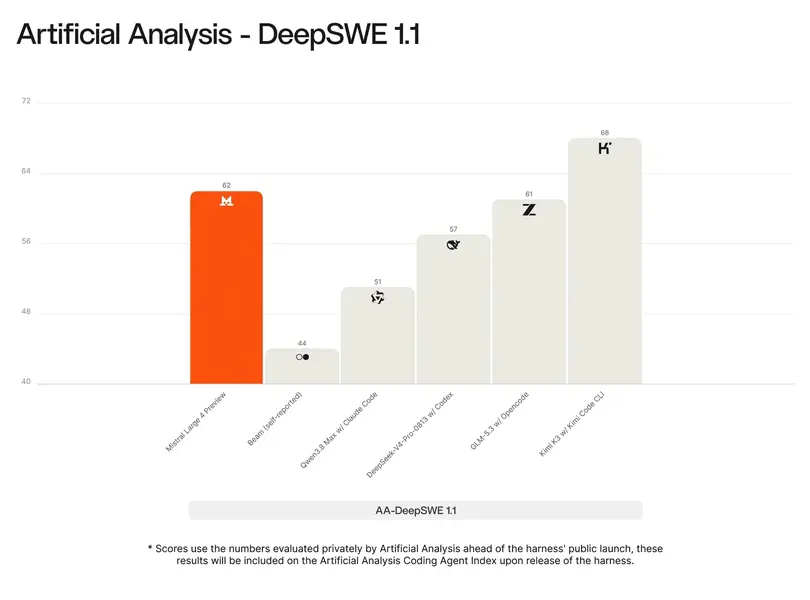
Nel materiale di lancio, Mistral riporta il 61,7% su DeepSWE v1.1, dedicato al lavoro sul software, e il 59,9% su AutomationBench, che comprende 657 flussi aziendali. Sono risultati pubblicati dal produttore: descrivono la capacità di portare avanti compiti articolati, ma non garantiscono la stessa affidabilità nei processi di un cliente.

Un agente deve infatti collegare più passaggi: recuperare informazioni, scegliere uno strumento, interpretarne il risultato e decidere come continuare. Un errore iniziale può propagarsi fino al documento finale, anche quando quest’ultimo appare ben scritto. Per questo, prima di affidargli un’attività, serve verificare quali operazioni possa eseguire e in quali momenti debba chiedere un intervento umano.
È un aspetto che attraversa la competizione di queste settimane, come abbiamo raccontato parlando di GPT-6 Sol e Luna e del loro posizionamento tra coding, agenti e costi. Per chi acquista il servizio, il confronto utile riguarda il lavoro completato correttamente, il tempo impiegato e quanto costa controllarlo.
Anche nella visione bisogna leggere il risultato specifico. Mistral dichiara il 42% su Dense 200 contro il 41% di GPT-6 Astra nel visual grounding, cioè nell’associare una richiesta a una posizione nell’immagine. È una funzione utile, per esempio, per individuare un componente in un disegno tecnico. Un punto percentuale in quel test non dimostra una superiorità generale nell’interpretazione delle immagini.
La sovranità si misura anche nei server
Secondo Mistral, Large 4 è stato addestrato da zero su 3.800 GPU NVIDIA Grace Blackwell nei propri centri dati europei, utilizzati anche per l’anteprima. Il gruppo dichiara inoltre dati di addestramento in oltre 160 lingue, comprese tutte quelle ufficiali dell’Unione europea. La presenza di una lingua nei dati, naturalmente, non certifica la qualità delle risposte in quella lingua.
Il controllo dell’infrastruttura dà sostanza al discorso sulla sovranità tecnologica, purché si chiarisca che cosa comprende. Scegliere dove elaborare le informazioni e chi amministra il servizio può ridurre alcune dipendenze; non elimina quelle dai produttori di semiconduttori, dall’energia o dal software necessario a far funzionare il sistema.
Anche open weight e open source non sono sinonimi automatici. Rendere disponibili i parametri permette di eseguire e studiare il modello, nei limiti della licenza, ma non implica che siano pubblici tutti i dati e gli strumenti necessari a ricrearne l’addestramento. Le condizioni effettive andranno lette insieme al rilascio, senza dedurle dalla sola promessa di apertura.
La prova per le aziende comincia adesso
Nel riquadro prezzi dell’annuncio, Mistral indica 1,36 dollari per milione di token in ingresso e 4,18 dollari per milione in uscita. Sono tariffe API riportate al lancio, da ricontrollare al momento dell’utilizzo. Non descrivono il costo di un’installazione autonoma, che richiede un calcolo diverso tra hardware, personale, energia e manutenzione.
La possibilità di scegliere fra servizio gestito e infrastruttura propria apre comunque una valutazione concreta. Un’azienda potrà chiedersi se convenga pagare ogni utilizzo, tenere internamente i carichi più sensibili oppure distribuire attività diverse su sistemi differenti. Nessuna delle tre strade è conveniente in assoluto: dipende dai volumi e dal lavoro richiesto.
Large 4 merita quindi attenzione come possibile fornitore di capacità tecniche sotto un controllo più diretto. La verifica decisiva sarà su documenti, programmi e procedure reali: quanto spesso completa il compito, quali errori commette e quanto lavoro resta alle persone. È lì che un buon risultato in classifica può diventare un vantaggio operativo, oppure perdere gran parte del suo valore.


