Per offrire più intelligenza artificiale non basta costruire nuovi data center: bisogna ottenere più lavoro dall’elettricità disponibile. È su questo terreno che Microsoft presenta Maia 300, terza generazione dei suoi acceleratori per l’AI. L’annuncio del 12 ottobre prevede l’avvio delle installazioni operative nel 2027 e un’espansione della famiglia Maia su scala di più gigawatt, fino a farne il principale sistema per l’inferenza dei prodotti e servizi Microsoft.
Il dato da osservare è il 40% di token in più per megawatt che l’azienda si aspetta rispetto ai principali sistemi basati su processori grafici, o GPU. I token sono le unità con cui un modello elabora e genera contenuti, spesso frammenti di parole. La promessa riguarda quindi quanta AI si può erogare entro una determinata potenza elettrica disponibile.
Da Maia 200 agli agenti che lavorano più a lungo
Avevamo già parlato di Maia: con Maia 200, presentato a gennaio 2026, Microsoft aveva puntato sull’inferenza, cioè l’esecuzione di modelli già addestrati. È ciò che avviene quando chiediamo a un assistente di riassumere un documento o scrivere codice. Il chip, prodotto da TSMC a 3 nanometri, abbinava calcolo specializzato e memoria veloce per contenere il costo di queste operazioni.
Ora Microsoft comunica che Maia 200 serve carichi reali, incluso Copilot; GitHub Copilot e Microsoft Foundry seguiranno entro fine anno. Il progetto ha quindi superato la fase dimostrativa.
Nel frattempo cambia il lavoro richiesto all’hardware. Come raccontato nel nostro approfondimento sulla strategia AI di Microsoft, un agente può eseguire una sequenza di azioni. Per correggere un programma deve leggere file, proporre modifiche, verificare risultati e riprovare. Ogni passaggio aggiunge elaborazioni e informazioni da conservare.
Maia 300 prova a far viaggiare meno dati
Un processore può essere velocissimo e restare comunque in attesa: succede quando la memoria non gli consegna abbastanza rapidamente i dati. Nei modelli linguistici bisogna mantenere disponibili sia i parametri del modello sia informazioni sui contenuti già elaborati. Questa memoria di lavoro cresce con la lunghezza della conversazione.
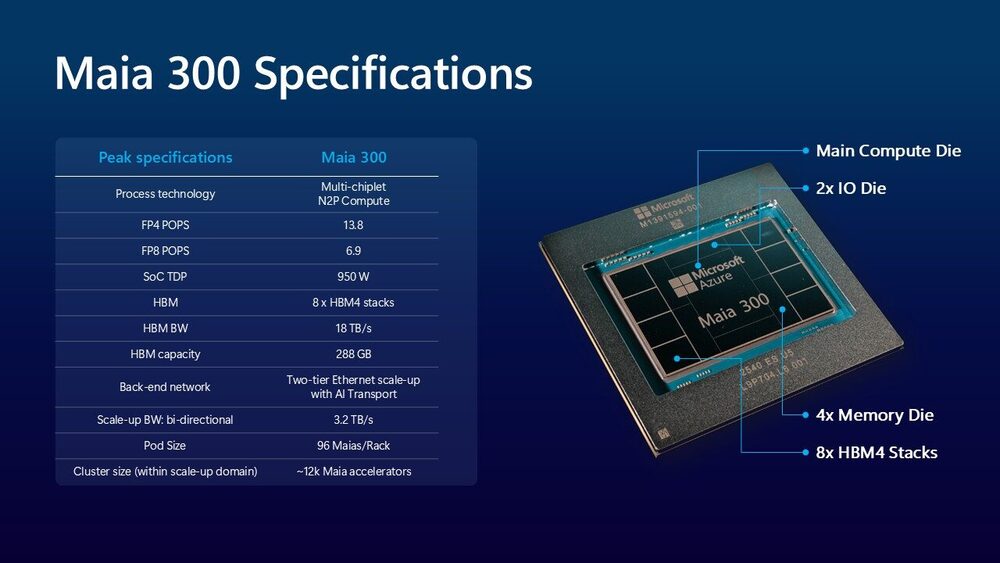
Maia 300 affronta il problema con 288 GB di memoria HBM4 e una banda di 18 TB/s per acceleratore. HBM significa memoria ad alta larghezza di banda: conta quanto rapidamente alimenta il calcolo, oltre a quanto contiene.
Il chip è composto da più elementi di silicio, i chiplet. Quelli dedicati al calcolo usano il processo TSMC N2P; altre funzioni sono separate. Il software dispone i dati vicino alle unità che devono elaborarli e ne coordina gli spostamenti. Percorsi più brevi significano meno energia spesa nel trasferimento.
Entrano in gioco anche rappresentazioni numeriche compatte, come MXFP4: usare meno bit riduce memoria occupata e dati da trasferire. Il compromesso richiede però verifiche sulla qualità del modello, perché ridurre la precisione dei numeri può influenzare i risultati.
Perché conta tutto l’armadio
Microsoft integra 96 acceleratori in un rack da 167 kW, l’armadio che ospita i server. La rete può collegarne fino a 12.288 nello stesso insieme di calcolo. Il raffreddamento a liquido smaltisce oltre l’80% del carico termico del rack.

Il confronto dichiarato con Maia 200 arriva fino a sette volte il flusso di token per rack. Ma il nuovo armadio contiene anche il doppio degli acceleratori: non è una misura della velocità del singolo chip, né significa aspettare sette volte meno una risposta.
Per valutare quel vantaggio servono modello, precisione numerica, lunghezza delle richieste e tempi di risposta ammessi. Anche il confronto del 40% con le GPU resta una stima aziendale: l’annuncio non identifica una configurazione concorrente e un protocollo completo che permettano di riprodurlo.
Che cosa può cambiare per chi usa l’AI
La conseguenza plausibile è poter servire più utenti, mantenere conversazioni più lunghe o sostenere agenti più impegnativi a parità di risorse. Non equivale a un taglio già annunciato degli abbonamenti: il risparmio può finanziare nuove funzioni oppure migliorare i margini.
Progettare insieme hardware, modelli e applicazioni permette inoltre a Microsoft di adattare l’infrastruttura al lavoro che conosce attraverso i propri servizi. La nostra lettura è che Maia rafforzi anche il controllo sui costi e sulle scelte tecnologiche.
Resta un punto decisivo: maggiore efficienza per operazione non garantisce minori consumi complessivi. Se gli utilizzi crescono più rapidamente dei risparmi, la domanda elettrica aumenta. Dal 2027 la verifica sarà quanta capacità utile Microsoft riuscirà a ricavare da queste installazioni, e a quali condizioni la renderà accessibile.


